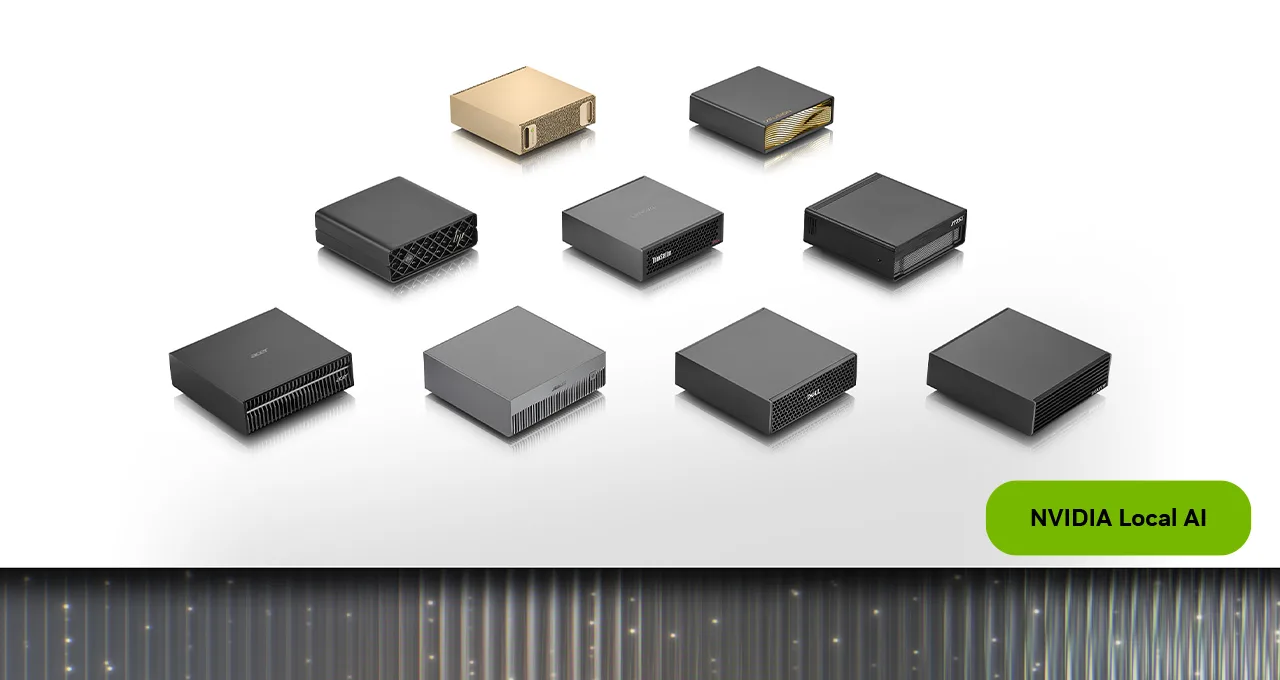
DGX Spark tendrá una configuración de 64 GB a partir del 23 de octubre, ofrecida por Acer, ASUS, Dell, Gigabyte, HP y MSI. NVIDIA anunció un precio de partida de 4.999 dólares para estos equipos, conservando el superchip GB10 Grace Blackwell y DGX OS. Para entender el cambio frente a la versión de 128 GB, la pregunta principal es cuánto espacio necesita el trabajo completo, además del modelo.
La plataforma reúne una CPU Arm de veinte núcleos y una GPU Blackwell con memoria unificada. La ficha de NVIDIA indica 273 GB/s de ancho de banda y hasta un petaflop de cálculo FP4. Son magnitudes diferentes: capacidad para alojar datos, velocidad para moverlos y capacidad aritmética bajo una precisión determinada. Ninguna, aislada, equivale a «respuestas por segundo».
Un cálculo que aterriza los 64 GB
Un modelo de 100.000 millones de parámetros almacenados a cuatro bits necesitaría, en un cálculo idealizado, 50.000 millones de bytes sólo para esos valores: 100.000 millones × 4 ÷ 8. Son 50 GB decimales antes de metadatos de cuantización y otros componentes. El ejemplo explica por qué NVIDIA habla de modelos de hasta 100.000 millones de parámetros, pero también por qué esa cifra no describe cualquier forma de ejecutarlos.
Durante la inferencia se necesita espacio adicional para el contexto, las cachés, los resultados intermedios, el sistema operativo y otras aplicaciones. Un modelo que cabe con una conversación corta puede encontrar límites al ampliar el contexto o atender varias solicitudes. Cambiar precisión o cuantización puede reducir memoria, con efectos que deben evaluarse sobre calidad y velocidad.
La memoria unificada facilita que CPU y GPU accedan al mismo conjunto de datos. No crea capacidad adicional: los 64 GB se comparten entre cargas. Una comparación útil entre configuraciones debe fijar modelo, precisión, longitud de entrada, tamaño de salida y número de usuarios concurrentes. Sin esas condiciones, una prueba de rendimiento puede estar midiendo una tarea distinta.
Dos Spark: más margen, con un coste de comunicación
NVIDIA permite conectar dos unidades de 64 GB mediante ConnectX-7 y configurarlas con Sync Cluster Assistant. La compañía reporta hasta 1,7 veces el rendimiento de una unidad en su prueba con Qwen 3.8 27B. Es un resultado concreto del fabricante, no una regla según la cual cualquier programa se vuelve un 70 % más rápido.
Distribuir un modelo implica intercambiar datos entre equipos. El software debe soportar esa distribución y el beneficio depende de cuánto trabajo se reparte frente a cuánto tiempo ocupa comunicarse. Dos memorias de 64 GB tampoco se convierten, para cualquier aplicación, en una única memoria local transparente de 128 GB.
El software también forma parte de la configuración
Las notas actuales de la Founders Edition indican DGX OS 7.5.0, controlador 580.159.03 y CUDA 13.0.2. NVIDIA advierte que los equipos de socios pueden recibir actualizaciones en momentos diferentes. La versión de software debe acompañar a cualquier comparación, porque la gestión de memoria y los problemas corregidos pueden cambiar el resultado.
Para un proyecto de IA local, conviene medir tiempo hasta el primer token, velocidad de generación, consumo de memoria y calidad en tareas propias. La guía de usos de DGX Spark concreta tres recorridos. El precio en dólares del anuncio sigue siendo una referencia de lanzamiento: disponibilidad, almacenamiento y soporte en México dependen de cada configuración comercial.